MAQ 官網的「AI 諮詢」線上客服,是在本地執行的大型語言模型:客人詢問機型、預算與規格時,模型會呼叫查詢機型、計算配置價格、產生報價單等工具,再依工具回傳的資料回答。為了評估消費級顯示卡能否承擔這類工作,MAQ 在 2026 年 9 月以 RTX 5090 與 RTX 5070 Ti 兩台測試機,量測讀取提示與生成答案的速度、多人同時使用時的表現,並以真實客服情境檢驗模型能否正確完成工作。本文整理全部數字與測試方法。
測試條件
| 項目 | RTX 5090 測試機 | RTX 5070 Ti 測試機 |
|---|---|---|
| 顯示卡 | RTX 5090 32GB(功耗上限 600W) | RTX 5070 Ti 16GB(功耗上限 300W) |
| 處理器/系統記憶體 | 4 vCPU/15GB | Intel Core i5-11500(4 vCPU)/23GB |
| 推論引擎 | ollama 0.32.14 | ollama 0.34.2 |
| 測試模型 | gemma4 26B MoE(Q4_K_M,模型檔 17GB) | gemma4 e4b(8B,Q4_K_M,9.6GB);gpt-oss 20B(MXFP4,13GB) |
| 共同設定 | 脈絡長度 65,536 token、Flash Attention、關閉思考模式(gpt-oss 無法關閉,設為 low) | |
gemma4 26B MoE 是 MAQ 線上客服目前使用的模型。它的模型檔有 17GB,放不進 RTX 5070 Ti 的 16GB 顯示記憶體,因此 RTX 5070 Ti 改測兩顆放得下的模型:8B 級的 gemma4 e4b,以及 20B 級的 gpt-oss 20B。兩台測試機的 ollama 版本不同,比較數字時請留意這項差異。
一、單人速度:讀取提示與生成答案
語言模型回答問題分兩個階段:先一次讀完整段提示(prefill),再逐一生成答案(decode)。前者決定客人送出問題後多久看到第一個字,後者決定答案出現的速度。每個提示長度量測兩次取中位數,提示前加上唯一字串,避免命中快取。
RTX 5090/gemma4 26B MoE
| 提示長度 | 讀取提示 | 生成答案 | 首字時間 |
|---|---|---|---|
| 1,533 token | 10,710 tok/s | 219 tok/s | 0.49 秒 |
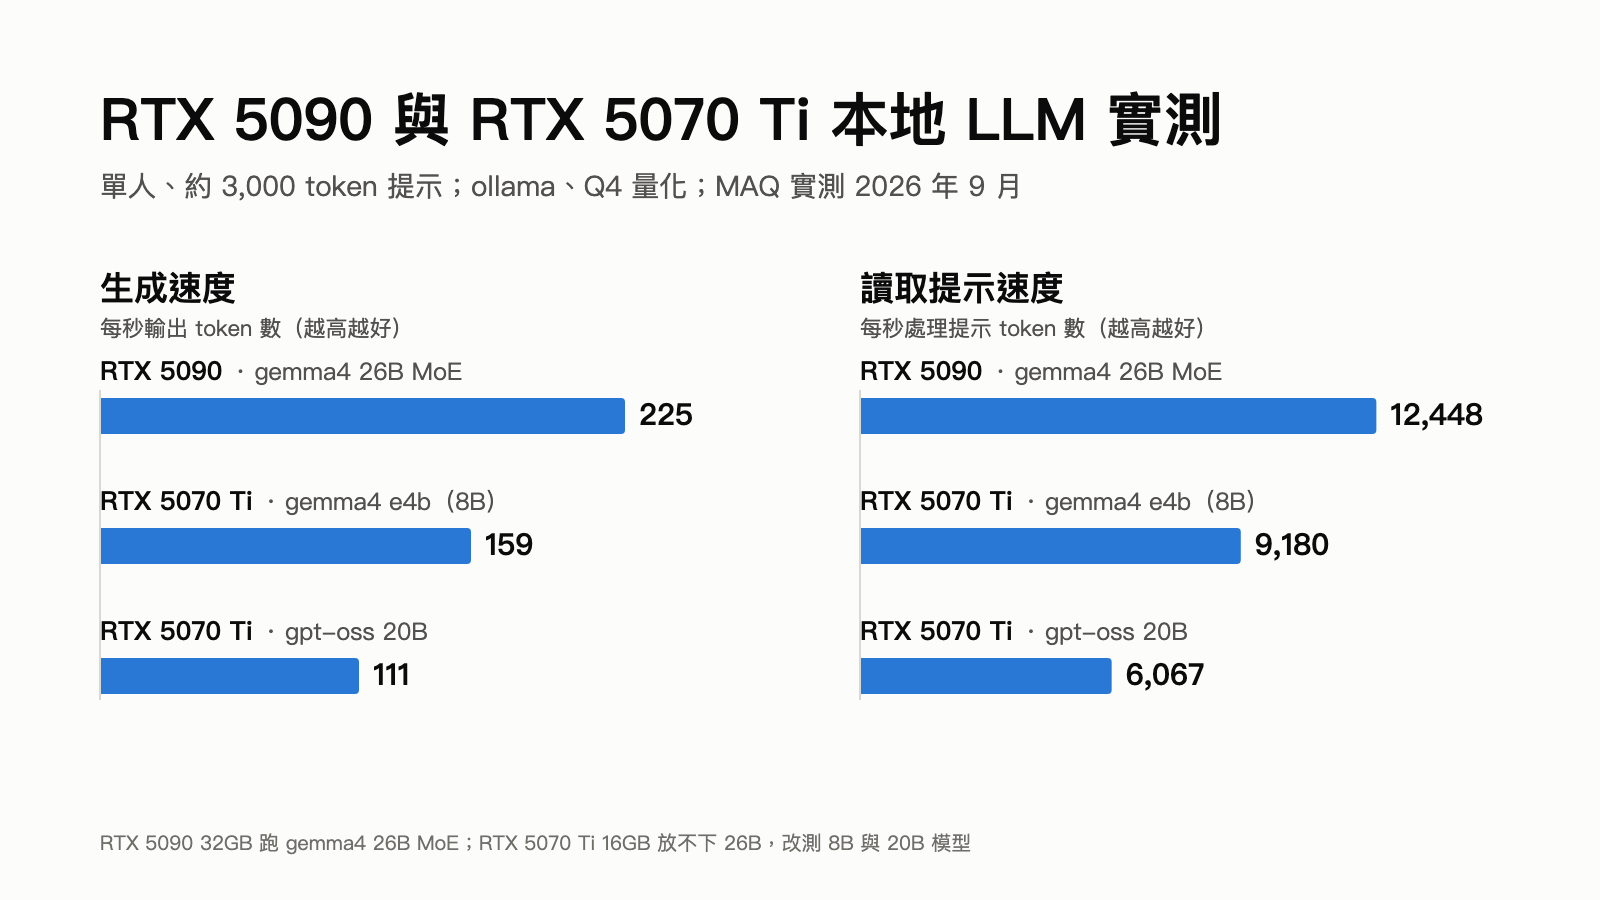
| 3,048 token | 12,448 tok/s | 225 tok/s | 0.64 秒 |
| 5,941 token | 13,948 tok/s | 230 tok/s | 0.83 秒 |
| 12,024 token | 14,262 tok/s | 233 tok/s | 1.27 秒 |
| 23,823 token | 13,583 tok/s | 224 tok/s | 2.26 秒 |
RTX 5070 Ti/gemma4 e4b(8B)
| 提示長度 | 讀取提示 | 生成答案 | 首字時間 |
|---|---|---|---|
| 1,545 token | 8,383 tok/s | 161 tok/s | 0.21 秒 |
| 3,043 token | 9,180 tok/s | 159 tok/s | 0.37 秒 |
| 5,984 token | 9,315 tok/s | 156 tok/s | 0.70 秒 |
| 11,921 token | 9,046 tok/s | 151 tok/s | 1.41 秒 |
| 23,813 token | 8,085 tok/s | 143 tok/s | 3.13 秒 |
RTX 5070 Ti/gpt-oss 20B(首字時間包含模型的思考時間)
| 提示長度 | 讀取提示 | 生成答案 | 首字時間 |
|---|---|---|---|
| 1,836 token | 5,440 tok/s | 112 tok/s | 0.52 秒 |
| 3,556 token | 6,067 tok/s | 111 tok/s | 0.78 秒 |
| 7,057 token | 6,041 tok/s | 109 tok/s | 1.40 秒 |
| 13,910 token | 5,917 tok/s | 65 tok/s | 5.09 秒 |
| 28,010 token | 5,604 tok/s | 103 tok/s | 5.77 秒 |
RTX 5090 跑 26B MoE 模型,生成速度穩定在每秒 220 至 235 個 token,幾乎不受提示長度影響;兩萬多 token 的長提示,第一個字在 2.3 秒內出現。RTX 5070 Ti 跑 8B 模型全部放在顯示記憶體內,含 64K 脈絡只使用 6.5GB,生成速度約每秒 150 個 token。gpt-oss 20B 在 64K 脈絡下總需求約 13.5GB,顯示卡只容納得下 11.5GB,其餘約 2GB 落到 CPU 執行,生成速度降至每秒約 110 個 token,長提示時更低。
二、多人同時使用
線上客服會有多位訪客同時詢問。測試模擬真實客服:每個請求共用約 3,000 token 的系統提示,再加上各自不同的問題,輸出上限 300 token,同時送出 1 至 16 個請求。ollama 的並行槽數(同時處理的請求數)另行調整比較,每種設定重啟後先暖機一輪,採用第二輪結果。
RTX 5090/gemma4 26B MoE,並行槽數 2
| 同時人數 | 首字時間(中位/最慢) | 完成時間(中位/最慢) | 總吞吐 |
|---|---|---|---|
| 1 | 0.40/0.40 秒 | 1.69/1.69 秒 | 177 tok/s |
| 2 | 0.58/0.68 秒 | 2.27/2.28 秒 | 263 tok/s |
| 4 | 1.84/2.91 秒 | 3.51/4.57 秒 | 263 tok/s |
| 8 | 5.70/8.71 秒 | 7.40/10.36 秒 | 221 tok/s |
| 16 | 9.94/17.41 秒 | 11.75/18.90 秒 | 244 tok/s |
RTX 5070 Ti/gemma4 e4b,並行槽數 4
| 同時人數 | 首字時間(中位/最慢) | 完成時間(中位/最慢) | 總吞吐 |
|---|---|---|---|
| 1 | 0.08/0.08 秒 | 1.98/1.98 秒 | 152 tok/s |
| 2 | 0.05/0.05 秒 | 2.18/2.18 秒 | 275 tok/s |
| 4 | 0.15/0.15 秒 | 3.13/3.14 秒 | 383 tok/s |
| 8 | 1.89/3.54 秒 | 4.31/6.37 秒 | 357 tok/s |
| 16 | 4.68/10.16 秒 | 7.13/13.86 秒 | 324 tok/s |
- RTX 5090:並行槽數維持 2。總吞吐在 2 人時即達約每秒 260 個 token,超過的請求排隊等候,首字時間隨人數拉長,但 16 人同時送出仍全部完成。改為並行槽數 4 時,8 至 16 人的最慢完成時間約縮短 25%(16 人最慢 14.4 秒),但 4 人時每人生成速度降至約每秒 120 個 token,反而較慢。
- RTX 5090:並行槽數 8 不可用。在 64K 脈絡下,模型與快取共佔 30.7GB,只剩約 2GB。16 人同時送出時推論程序因顯示記憶體不足而中止,當下全部請求失敗,模型重新載入後才恢復。
- RTX 5070 Ti:小模型適合較多並行槽數。並行槽數 4 只使用 8.7GB 顯示記憶體,4 人同時使用時總吞吐達每秒 383 個 token。表中極短的首字時間,是因為共用的系統提示命中快取;兩台測試機的 ollama 版本不同,快取行為的差異未另行區分。
三、小模型能否勝任客服
速度只是條件之一。客服需要依序呼叫多個工具並判斷結果,例如先查機型、再查可選配置、最後計算價格。MAQ 以 12 個真實客服情境,走官網 AI 諮詢的實際程式,比較 RTX 5070 Ti 上的 gemma4 e4b 與目前線上使用的 gemma4 26B。對照組的 26B 在 MAQ 內部一台 AMD Radeon AI PRO R9700 32GB 主機上執行。其中產生報價單的情境受測試環境限制無法判定,不計入。
| 情境類型 | gemma4 e4b(RTX 5070 Ti) | gemma4 26B(R9700) |
|---|---|---|
| 單步驟:保固與備機、轉接真人、依規格報價、換顯示卡算價、查詢特定顯示卡的機型、簡體中文提問、無關閒聊(8 題) | 8 題全部正確 | 8 題全部正確 |
| 預算三萬以內的遊戲主機 | 未查詢遊戲機型,回覆與需求無關 | 正確,說明最低價機型並附連結 |
| Mac Studio 256GB 追問升級 CPU 後的總價 | 追問時工具呼叫次數超過上限,未能回答 | 正確查詢選配並算出總價 |
| 50 人文件問答、預算 50 萬 | 列出四台含超出預算的機型,重點不清 | 推薦兩台並說明理由 |
| 12 情境總耗時 | 約 49 秒 | 約 83 秒 |
8B 模型在一步就能完成的問題上表現正確,而且速度較快;需要連續查詢與判斷的問題,則出現答非所問或無法完成。同一顆 26B 模型換到不同顯示卡,工具呼叫的結果一致,差別只在速度:前台 8 題工具測試中,RTX 5090 為 30.4 秒,R9700 為 41.4 秒,兩者都 8 題全對。
四、選購判讀
- 模型大小決定能力,顯示記憶體決定能放多大的模型。要讓 AI 處理需要多步驟判斷的工作,例如客服、報價與知識問答,26B 級模型明顯較可靠;這個等級搭配 64K 脈絡,需要 32GB 級的顯示記憶體。
- 16GB 適合 8B 級模型與單步驟任務。例如常見問題回覆、分類與轉接。20B 級模型在 16GB 上已有部分落到 CPU,速度與穩定性都打折。
- 同時在線人數取決於總吞吐。以 RTX 5090 跑 26B MoE、每輪對話約 400 至 600 個輸出 token 估算,約 15 至 20 人同時在線時回覆仍順暢,約 30 人為上限;這是依實測吞吐換算的估計值,並非實際量測。
- 系統記憶體也要留足。RTX 5090 測試機只有 15GB 系統記憶體,放不下 17GB 的模型檔快取,每次重啟都要從磁碟重新載入,約需 67 至 82 秒。建議系統記憶體不小於模型檔大小。
MAQ 的 AI 工作站中,AI-Medium 採用 AMD Radeon AI PRO R9700 32GB,即本文對照組使用的顯示卡,可在本機執行 26B 級模型;RTX 5070 Ti 16GB 則用於剪輯、CAD 與入門 AI 工作站。可依預計使用的模型、同時在線人數與提示長度,協助評估合適的配置。
延伸閱讀
- RTX PRO 6000 96GB 雙卡實測:gpt-oss-120b 推論吞吐、7B 微調訓練與雙卡擴展效率
- M5 Ultra 對 M3 Ultra 本地 AI 實測:長提示的等待縮短為四分之一,文字生成快 1.5 倍
- 本週 AI 三件事:Jev、Laya、Kev 開啟「決策模型」新品類
資料說明:本文數據為 MAQ 於 2026 年 9 月 24 至 25 日自行測試。兩台測試機皆為 4 vCPU 等級的主機,ollama 版本不同(RTX 5090 為 0.32.14、RTX 5070 Ti 為 0.34.2),多人同時與客服情境測試為單次量測,同設定重跑的差異約 ±10%。客服情境使用 MAQ 官網 AI 諮詢的實際程式與題目,結果會隨提示內容與工具版本調整而變動。同時在線人數為依實測吞吐換算的估計值。NVIDIA、GeForce RTX 為 NVIDIA Corporation 商標;AMD、Radeon 為 Advanced Micro Devices, Inc. 商標;Gemma 為 Google LLC 商標;文中其他商標均屬各該公司所有。